


非层次聚类方法
5. 非层次聚类方法(Non-hierarchical clustering methods)
非层次聚类方法从以下二者之一出发:
- 将对象初始划分为若干组,或
- 一组初始种子点,它们将构成各簇的核心。
一旦指定了要形成的簇数,对象便会被分配到各簇中。
六簇解并不是由七簇解中的两个簇简单组合而成,而是通过直接寻找最优的六簇解得到的。
5.1 K-means 方法
5.1.1 步骤
- 将对象初始划分为 个簇。
- 随机分配或预先指定。
- 计算各簇的质心。
- 逐一遍历各对象,将每个对象分配到质心(均值)距其最近的簇。
- 重复第 2、3 步,直到不再发生重新分配为止。
对象到簇的最终分配在一定程度上取决于初始划分或种子点的初始选取。
5.2 K-means 示例
对四个对象测量两个变量 和 :
| 对象 | ||
|---|---|---|
| A | 5 | 3 |
| B | -1 | 1 |
| C | 1 | -2 |
| D | -3 | -2 |
目标是将这些对象划分为
个簇。
第 1 步:初始划分
任意地将对象划分为:
- 簇 1:
- 簇 2:
初始质心为:
| 簇 | 成员 | ||
|---|---|---|---|
| 1 | 2 | 2 | |
| 2 | -1 | -2 |
质心(centroid)就是簇内所有成员在每个变量上的均值。
第 2 步:到初始质心(centroids)的距离
对于对象 A:
A 距簇 1 更近,因此不重新分配。
对于对象 B:
B 距簇 2 更近,因此将 B 重新分配到簇 2。
所有对象到两个质心的平方距离为:
| 簇质心 | A | B | C | D |
|---|---|---|---|---|
| 10 | 10 | 17 | 41 | |
| 61 | 9 | 4 | 4 |
C 和 D 距簇 2 更近,因此它们留在簇 2 中。
更新后的质心
簇变为:
- 簇 1:A
- 簇 2:
它们的质心为:
| 簇 | 成员 | ||
|---|---|---|---|
| 1 | A | 5 | 3 |
| 2 | -1 | -1 |
新的平方距离为:
| 簇质心 | A | B | C | D |
|---|---|---|---|---|
| A | 0 | 40 | 41 | 89 |
| 52 | 4 | 5 | 5 |
不再发生进一步的重新分配。
最终的 个簇为:
- 簇 1:A
- 簇 2:
6. 簇的数目
选择簇的数目需要在以下二者之间权衡:
- 中层管理者,他们可能偏好数量较少、范围较宽的战略性细分市场( 小),以及
- 销售人员,他们可能偏好数量较多、界定狭窄的细分市场( 大)。
讲义中讨论的准则包括:
- 簇间距离
- 方差比准则(Variance-ratio criterion)
- 轮廓系数(Silhouette coefficient)
- 簇的相对大小
6.1 方差比准则(Variance-ratio criterion)
方差比准则为
- :对象总数,整个数据集里有多少个观测对象。
- 以上面的例子为例,例子里有 A、B、C、D 四个对象,所以 .
- :簇的个数,即 K-means 里设定的 .
- :组间平方和(Between-group Sum of Squares),度量各簇之间分得有多开。
- :组内平方和(Error/Within-cluster Sum of Squares),度量每个簇内部有多紧凑。
其中,
式中:
- 是第 个簇中第 个变量的均值,
- 是第 个变量的总均值。
- :第 个簇的成员个数
6.1.1 整个 VRC 公式的含义
- :就是 ANOVA 里 F 统计量的核心——组间差异相对组内差异越大,说明簇分得越 “干净利落”。
- :自由度修正。 是 的自由度( 个质心相对总均值的变异), 是 的自由度( 个对象相对各自簇质心的变异)。乘上它才构成真正的 F 型统计量,使不同 之间可比。
所谓的“变异”,指的就是“参差不齐的程度”:一组数围绕某个参照点散得有多开。统计里度量它的标准做法是:
为什么平方?因为单纯算差值的话,正负会抵消(比如 +3 和 -3 加起来是 0,但明明散得很开)。平方之后全部为正,离参照点越远,惩罚越重。
所以,我们上面说“ 个质心相对总均值的变异”,翻译成人话就是,各个簇的中心点,离全体数据的中心点有多远(平方后加起来)。
自由度的含义是:在约束条件下,还能”自由变动”的数值个数。
我们可以用一个简单的例子来理解。假设我们有 3 个数,均值是 10,也就是说,总和固定为 30.
- 第一个数你可以随便取,比如 7 → 自由
- 第二个数也可以随便取,比如 2 → 自由
- 第三个数呢?没得选了,必须是 → 不自由
所以”3 个数 + 均值已知”这个约束下,只有 2 个数是自由的,自由度 = 3 - 1 = 2。
回到 VRC 的两个自由度, 的自由度是 ,我们可以想一想, 用到了 个质心,但这些质心是围绕总均值来算偏差的。关键事实是:所有质心(按簇大小加权)的平均恰好等于总均值——这是一个约束。和上面的例子一样, 个质心里只有 个能”自由跑”,最后一个被总均值锁死了。
而对于 ,它的自由度是 : 用到了全部 个对象,但每个对象是和自己簇的质心比较。每个簇内部都有一个约束:簇内成员的偏差之和必须为零(因为质心就是它们的均值)。一共有 个簇,就有 个约束,所以自由度 .
那么,为什么 VRC 要除以自由度?
这是因为 和 都是”加总”出来的量,加总的项越多,数值天然就越大,直接比不公平。类比一下:
- 3 个质心产生的 天然比 2 个质心的大——不是聚类更好,只是”分母项”多了;
- 100 个对象产生的 天然比 4 个对象的大。
除以自由度相当于算”平均每一份自由变动贡献了多少变异”,把它变成一个”单位化”的公平比值。这正是 F 统计量的标准构造:
可以看到,VRC 只是把分子分母调换写法,本质一模一样。也正因为做了这个校正,我们才能拿 的 VRC 和 的 VRC 直接比较大小——这正是 6.4 节那张表里”比较不同簇数的 VRC”做法合法的原因。
💡 记忆:BSS 看簇与簇之间(越大越好),ESS 看簇内部(越小越好),VRC 是两者之比再做自由度校正。
6.2 轮廓系数(Silhouette coefficient)
对于对象 ,
式中:
- = 对象 到同一簇中所有其他对象的平均距离,“我和我的队友有多近”;
- = 对象 到最近邻簇中所有对象的平均距离,“我和隔壁有多近”。
我们可以设想两种情形:
情形 1:(簇里不止自己一个人)
分子 是”离隔壁的距离”减去”离队友的距离”:
- :队友很近、隔壁很远 → 分对了!分子为正且大
- :两边差不多远 → 我站在边界上,分到哪边都说得过去
- :隔壁反而比队友更近 → 我可能被分错簇了!分子为负
分母为什么除以 ? 这是为了把结果归一化到 区间。可以验证两种极端:
- 完美聚类:(紧贴队友),此时
- 完全分错:,此时
这样不同对象、不同数据集的分数就可以直接比较了。
情形 2:(簇里只有自己)
如果簇里只有一个对象, 根本没法算(没有”队友”),所以约定 ——表示”无法评价”,既不表扬也不批评。
平均轮廓分数满足
解释:
- 取值接近 :被错误分类,
- 取值接近 :聚类良好。
也就是说,轮廓系数回答的问题就是:对象 待在现在这个簇里,合不合适?
6.3 示例:VRC 与轮廓系数
使用上一示例中最终的 解:
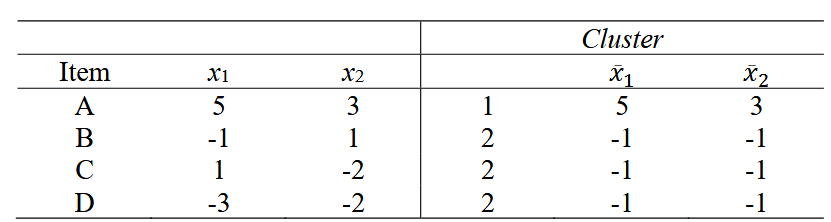
上图的 表示 A 属于簇 1,BCD 属于簇 2.
总均值为
则
上述四项的结构是:
且
因此,
四个对象之间的欧氏距离为:
| A | B | C | D | |
|---|---|---|---|---|
| A | 0 | 6.3246 | 6.4031 | 9.4340 |
| B | 6.3246 | 0 | 3.6056 | 3.6056 |
| C | 6.4031 | 3.6056 | 0 | 4.0000 |
| D | 9.4340 | 3.6056 | 4.0000 | 0 |
轮廓系数的计算如下:
| A | 0 | 7.3872 | 7.3872 | 0 |
| B | 3.6056 | 6.3246 | 6.3246 | 0.4299 |
| C | 3.8028 | 6.4031 | 6.4031 | 0.4061 |
| D | 3.8028 | 9.4340 | 9.4340 | 0.5969 |
从而,
6.4 示例 1:顾客支出细分
一项针对 24 名顾客的调查记录了其在九个类别上的支出百分比:
| 变量 | 类别 |
|---|---|
| 食品 | |
| 交通 | |
| 生活 | |
| 通讯 | |
| 娱乐 | |
| 其他 | |
| 衣着 | |
| 教育 | |
| 储蓄 |
目标是通过聚类分析进行细分。
6.4.1 方法
共有九个连续属性。
- 采用欧氏距离平方作为相异性度量。
- 对观测值进行标准化。
- 所考虑的层次凝聚方法:
- 单连接法,
- Ward 法。
6.4.2 标准化示例
原始数据为
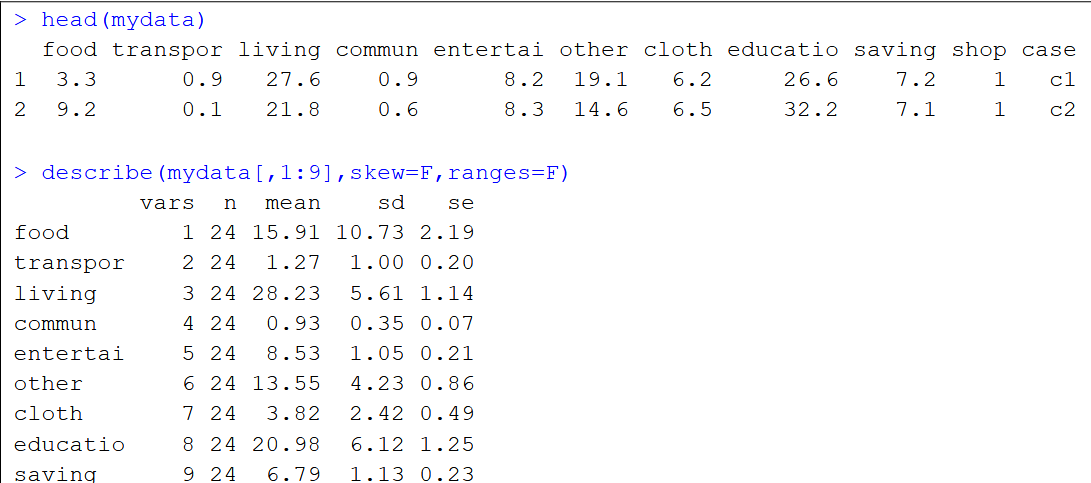
对于观测值 1,
且
对于 z-score 的含义,以上面的 -1.176 为例,它读作“这位顾客的食品支出比平均水平低 1.176 个标准差。”
对于观测值 1 和 2,标准化空间中的欧氏距离平方为
可以看出:
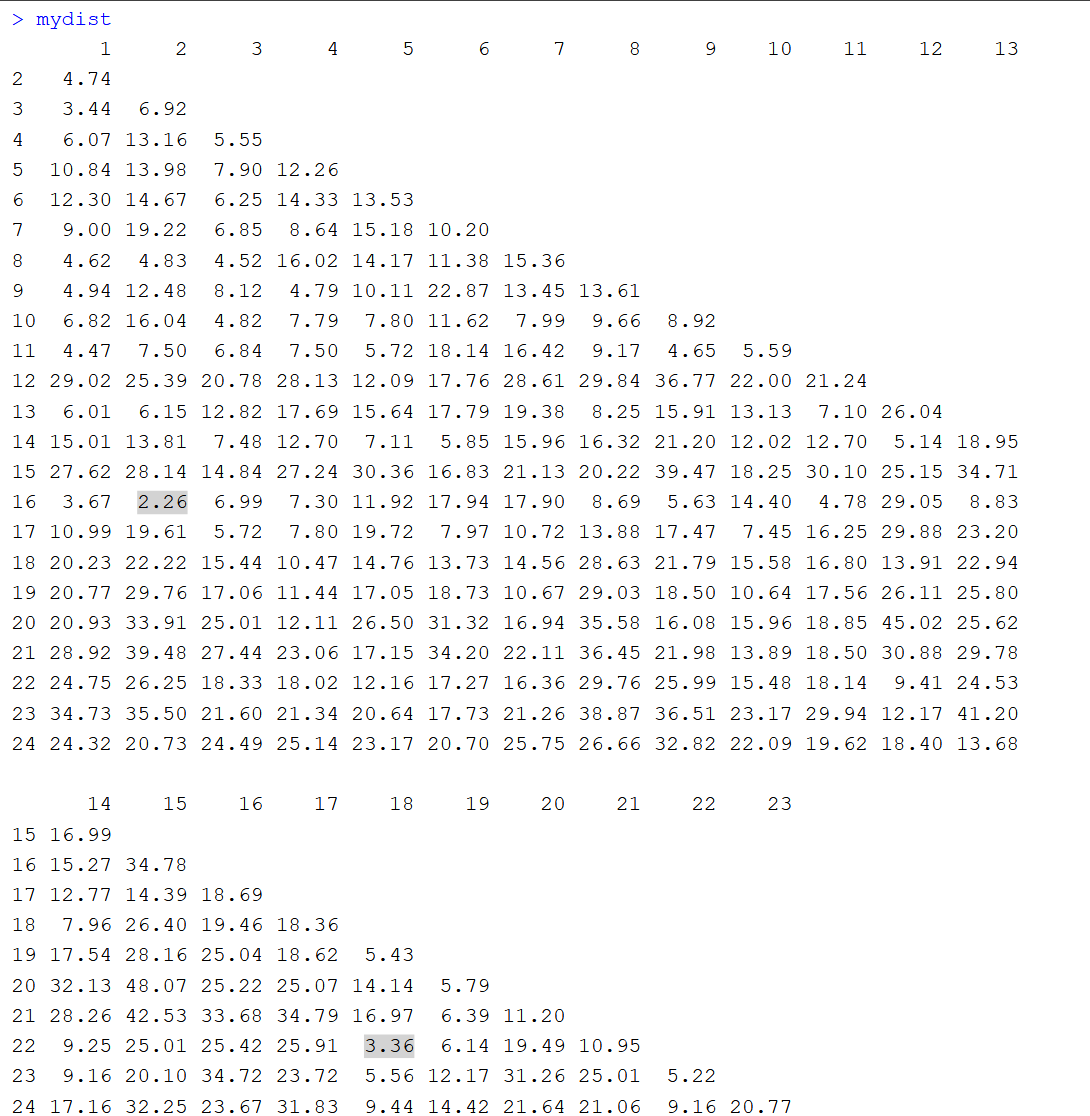
- 观测值 2 与 16 属于距离最近的一对,
- 观测值 18 与 22 也属于距离最近的一对。
6.4.3 单连接法
凝聚过程开始:
- 第 1 阶段:观测值 2 与 16 形成一个簇,距离 。
- 第 2 阶段:观测值 18 与 22 形成一个簇,距离 。
- 第 3 阶段:观测值 1 与 3 形成一个簇,距离 。
- 第 4 阶段:簇 与簇 合并,距离 。
- ……
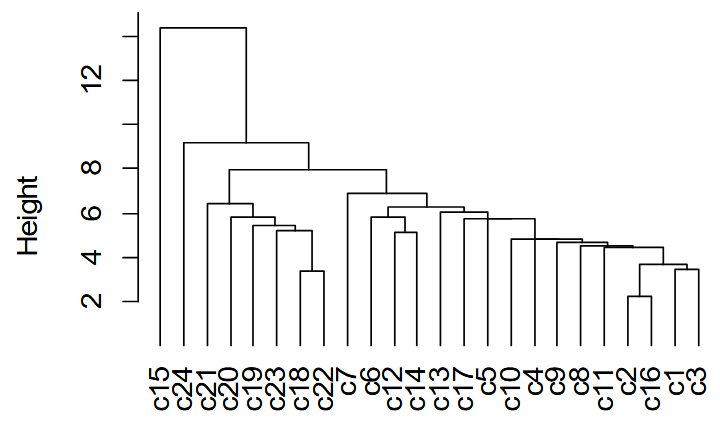
簇数准则为:
| 簇的数目 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|
| VRC | 2.1048 | 1.8285 | 4.3751 | 3.6540 |
| 轮廓系数 | 0.1983 | 0.0694 | 0.1631 | 0.0595 |
讲义中的观察:
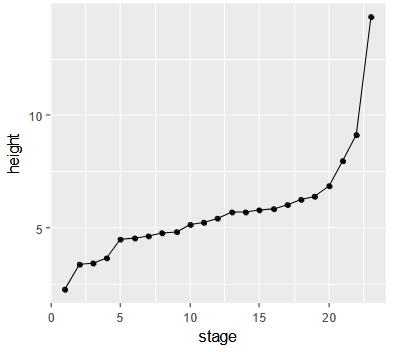
- VRC 最大:4 簇解。
- 轮廓系数最大:2 簇解。
- 距离图显示从 4 簇到 3 簇、或从 2 簇到 1 簇处出现跳跃。
- 讲义建议取 4 个簇。
这里简单介绍一下怎么读上面的图。
首先是 height 的含义:height = 该阶段合并两个簇时的距离(相异度),其实就是树状图的纵轴。凝聚聚类每一步都把”距离最近的两个簇”合并成一个,height 就记录这次合并花了多大的”代价”:
- height 小 → 合并的两个簇本来就很像,合并顺理成章
- height 大 → 被硬凑在一起的两个簇其实差异很大,合并很勉强
其次就是图的读法。读法是从右往左看:阶段越靠后,剩下的簇越少。
假定分为四个簇:
6.4.4 Ward 法
凝聚过程包括:
- 第 1 阶段:观测值 2 与 16 形成一个簇,
- 第 2 阶段:观测值 18 与 22 形成一个簇,
- ……
- 第 5 阶段:簇 与观测值 8 合并成一个簇。
讲义中展示的 Ward 更新公式为
代入所列数值,
簇数准则为:
| 簇的数目 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|
| VRC | 7.8698 | 6.9538 | 7.2853 | 6.7826 |
| 轮廓系数 | 0.2552 | 0.2243 | 0.2168 | 0.2133 |
讲义指出:
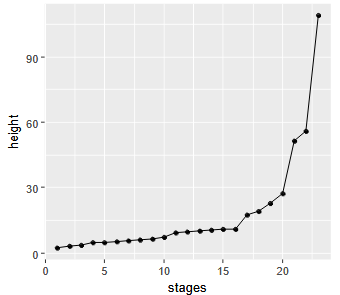
- VRC 最大:2 簇解。
- 轮廓系数最大:2 簇解。
- 距离图显示从 4 簇到 3 簇出现相对较大的增幅。
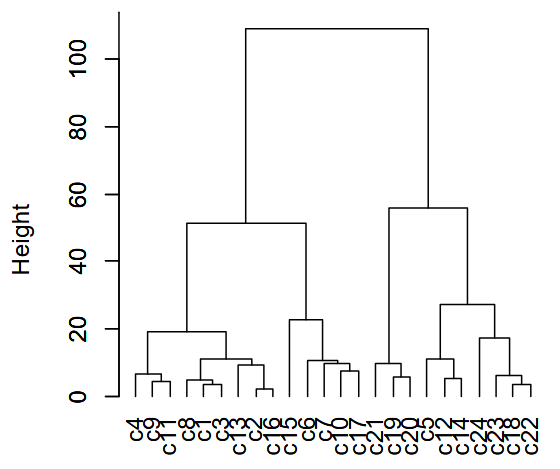
为了与单连接法解对比,讲义还给出了一种四簇的 Ward 解:
单连接法与 Ward 法的解并不相同。讲义指出,单连接法倾向于形成较大的簇。
6.4.5 四个 Ward 簇的解释
讲义将标准化均值轮廓总结如下:
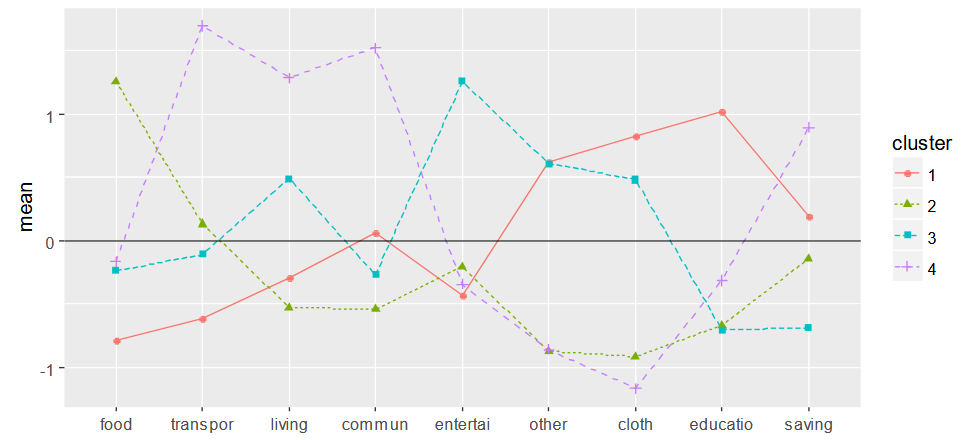
- C1: 在”其他、衣着、教育”方面支出占比较大;在”食品、交通”方面支出占比较小。
- C2: 在”食品”方面支出占比较大;在”生活、通讯”方面支出占比较小。
- C3: 在”娱乐”方面支出占比较大;在”教育、储蓄”方面支出占比较小。
- C4: 在”交通、生活、通讯、储蓄”方面支出占比较大;在”其他、衣着”方面支出占比较小。
6.5 示例 2:顾客面部特征
一个下午内共有 12 名顾客进入一家商店。
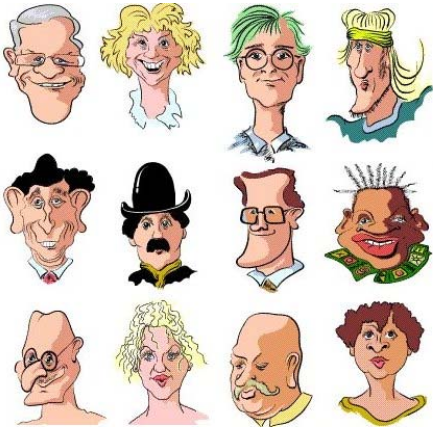
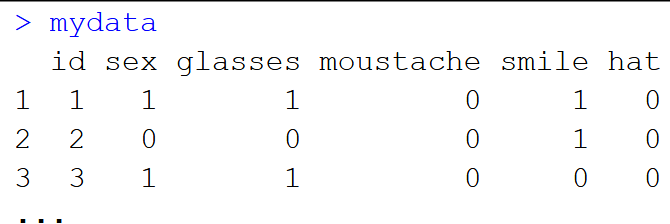
目标是基于五个二元面部特征对顾客进行细分:
- 性别
- 眼镜
- 胡须
- 微笑
- 帽子
6.5.1 方法
共有五个二元属性。
采用简单失配法(Simple mismatching):
- 对”是”与”否”两种取值均统计失配数,
- 并将该计数作为相异性度量。
采用完全连接法的层次凝聚方法。
邻近性度量为五个属性中失配特征的个数。
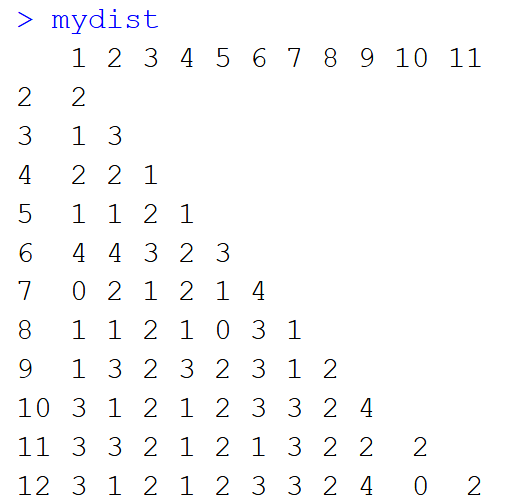
例如:
- 观测值 1 与 2 有两处失配,故距离 ,
- 观测值 1 与 3 有一处失配,故距离 。
对于完全连接法,簇间距离由分属两簇、彼此相距最远的两个观测值确定。
6.5.2 凝聚过程
讲义重点提到:
- 第 1 阶段:观测值 1 与 7 形成一个簇;失配数 。
- 之后:观测值 3 并入簇 ;失配距离 。
6.5.3 簇数目的选择
| 簇的数目 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|
| VRC | 13.03 | 16.75 | 17.79 | 15.55 |
VRC 在五簇时最大,但距离图显示从三簇到两簇出现大幅跳跃。
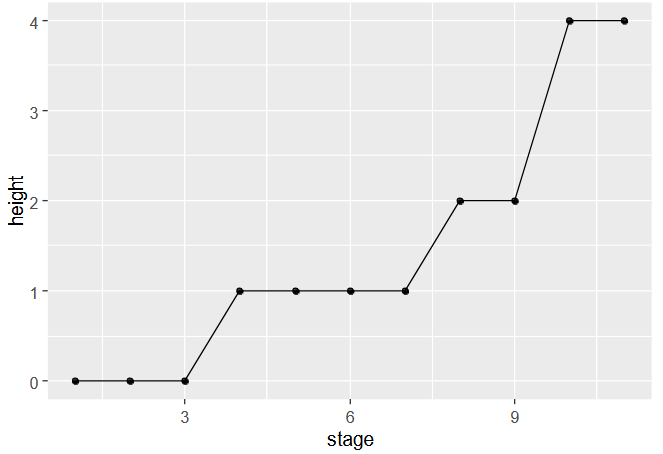
因此讲义建议采用三簇解:
6.5.4 簇轮廓
| 簇 | % 男性 | % 眼镜 | % 胡须 | % 微笑 | % 帽子 |
|---|---|---|---|---|---|
| C1 | 100 | 100 | 25 | 75 | 0 |
| C2 | 50 | 0 | 0 | 50 | 0 |
| C3 | 100 | 0 | 100 | 0 | 50 |
讲义给出的解释:
- C1: 男性、戴眼镜、不戴帽子。
- C2: 不戴眼镜、无胡须、不戴帽子。
- C3: 男性、不戴眼镜、有胡须、不微笑。
6.6 示例 3:美国公用事业公司
收集了 22 家美国公用事业公司 1975 年的数据。
变量如下:
| 变量 | 说明 |
|---|---|
| 固定费用保障比率(收益/债务) | |
| 资本回报率 | |
| 单位装机容量成本(每 KW) | |
| 年负荷率 | |
| 1974 至 1975 年高峰 KWH 需求增长 | |
| 销售量(每年 KWH 用电量) | |
| 核电百分比 | |
| 燃料总成本(美分/KWH) |
目标是通过聚类分析对这些公司进行定位。
6.6.1 方法
共有八个连续属性。
- 采用欧氏距离平方作为相异性度量。
- 对观测值进行标准化。
- 采用 K-means 方法。
6.6.2 簇的数目
| 2 | 3 | 4 | 5 | 6 | |
|---|---|---|---|---|---|
| VRC | 5.6093 | 6.0913 | 4.5813 | 5.5113 | 4.9967 |
| 轮廓系数 | 0.1853 | 0.2200 | 0.1169 | 0.1947 | 0.1343 |
讲义接下来在 5 个簇的假定下继续分析:
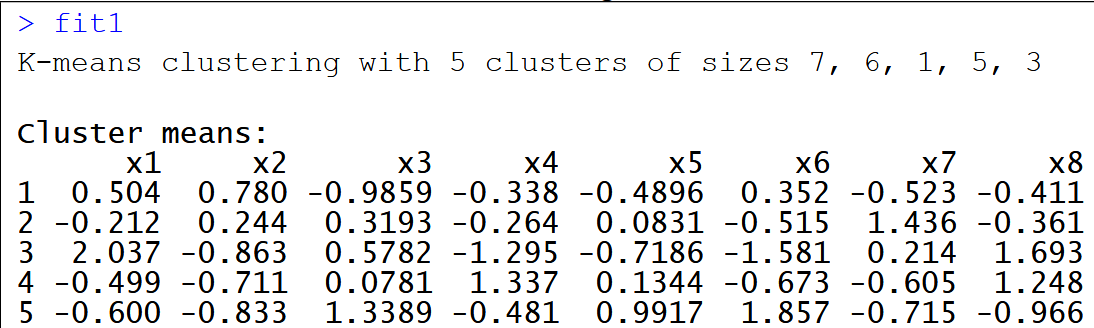
6.6.3 簇轮廓
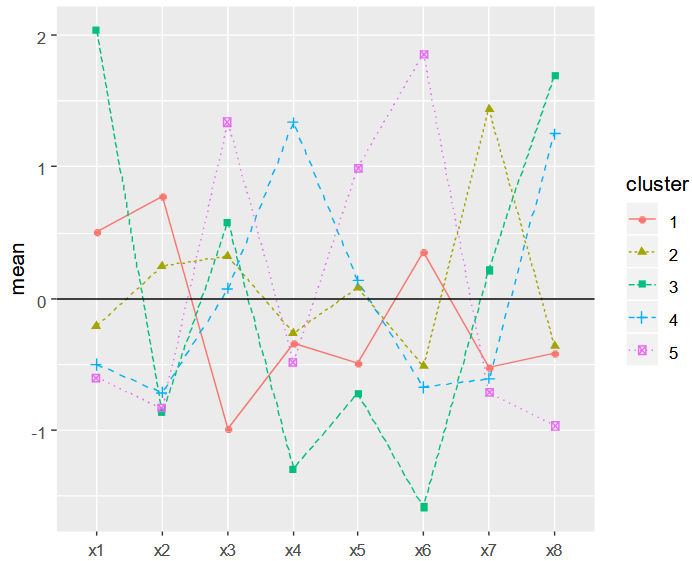
-
簇 1
- 7 家公司。
- 在资本回报率 上最高。
- 在成本 上最低。
-
簇 2
- 6 家公司。
- 在核电 上最高。
-
簇 3
- 1 家公司。
- 在固定费用保障比率 与燃料成本 上最高。
- 在资本回报率 、年负荷率 、高峰 KWH 需求增长 与销售量 上最低。
-
簇 4
- 5 家公司。
- 在年负荷率 与燃料成本 上最高。
- 在固定费用保障比率 、资本回报率 与核电 上最低。
-
簇 5
- 3 家公司。
- 在成本 、高峰 KWH 需求增长 与销售量 上最高。
- 在固定费用保障比率 、资本回报率 、核电 与燃料成本 上最低。
6.6.4 与 Ward 法的比较
讲义指出,对于这一五簇解,K-means 与 Ward 法的划分结果一致。
采用讲义中给出的 Ward 簇标签:
C1:南方公司群体
- Oklahoma Gas and Electric Company
- Texas Utilities Company
- Arizona Public Service
- The Southern Company
- Central Louisiana Electric Co.
- Kentucky Utilities Co.
- Florida Power & Light Co.
C2:东部+中部公司群体
- Madison Gas & Electric Co.
- Northern States Power Co.
- Commonwealth Edison Co.
- Wisconsin Electric Power Co.
- Boston Edison Co.
- Virginia Electric & Power Co.
C3:独立公司
- Consolidated Edison Co. (New York)
C4:东西部近海岸公司
- New England Electric Co.
- United Illuminating Co.
- Pacific Gas & Electric Co.
- Hawaiian Electric Co.
- San Diego Gas & Electric Co.
C5:西北部公司群体
- Idaho Power Co.
- Puget Sound Power & Light Co.
- Nevada Power Co.
6.6.5 地理解释
讲义的结论是:公用事业公司往往按地理位置聚成群体或展开竞争。
- C4:东部与西部,但靠近海岸。
- C2:东部+中部。
- C1:南部。
- C5:西北部。
- Consolidated Edison 独自成簇。
讲义给出的可能原因:
- 位置相近的公司往往在电厂中使用相似的燃料,并面对共同的市场,
- 因此这些公司在发电类型、成本、增长率及相关变量上应相对同质。
7. 与聚类的关联分析
7.1 单因素方差分析模型(1-way ANOVA model)
单因素方差分析研究以下两者之间的关系:
- 一个定量因变量(quantitative dependent variable),以及
- 一个定性自变量(qualitative independent variable)。
设:
- = 因子的水平数(Number of levels of factor),
- = 案例总数(Total number of cases)。
假设为
当下式成立时拒绝 :
显著性水平为 。
7.2 检验
检验研究两个定性变量之间的关系。
设:
- = 变量 A 的水平数,
- = 变量 B 的水平数。
假设为
当下式成立时拒绝 :
显著性水平为 。
7.3 示例:与顾客簇的关联分析
讲义提出以下问题:
- 各聚类变量在不同簇之间是否存在差异?
- 聚类结果与顾客类型之间是否存在关联?其中:
- shop :百货商店,
- shop :超市,
- shop :本地杂货店?
7.3.1 单因素方差分析
对标准化后的聚类变量进行单因素方差分析。
临界值为
| 变量 | p-value | |
|---|---|---|
| 食品 | 18.7 | |
| 交通 | 7.4 | 0.0016 |
| 生活 | 4.2 | 0.0186 |
| 通讯 | 4.59 | 0.0133 |
| 娱乐 | 5.3 | 0.0075 |
| 其他 | 8.46 | |
| 衣着 | 19.9 | |
| 教育 | 13.1 | |
| 储蓄 | 1.96 | 0.1528 |
[!result] 在 5% 显著性水平下,除储蓄外的所有聚类变量在四个簇之间均存在显著差异。
7.3.2 检验
带列百分比的二维频数表如下:
| 顾客类型 | 簇 1 | 簇 2 | 簇 3 | 簇 4 |
|---|---|---|---|---|
| 百货商店 | 6 (66.67%) | 1 (14.29%) | 2 (40.00%) | 0 (0%) |
| 超市 | 3 (33.33%) | 2 (28.57%) | 3 (60.00%) | 0 (0%) |
| 本地杂货店 | 0 (0%) | 4 (57.14%) | 0 (0%) | 3 (100%) |
检验统计量为
并且,
因此,商店类型与聚类结果之间存在关联。
讲义对各簇的刻画如下:
- 簇 1:百货商店
- 簇 2:本地杂货店
- 簇 3:超市
- 簇 4:本地杂货店
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放