


相似性度量
在聚类分析中,要产生一个简单的分组结构,我们就需要一种衡量接近程度或相似性的度量。
选择相似性度量时涉及很大的主观性。
本篇节选自我的课程笔记,因此标题序号沿用了原笔记中的排列(懒得改)。
3.1 连续型测量
对象可以用 维测量值表示:
欧氏距离(Euclidean distance)
欧氏距离就是两点间的直线距离,即勾股定理在高维的推广,是我们日常空间直觉中最自然的“距离”。
平方欧氏距离
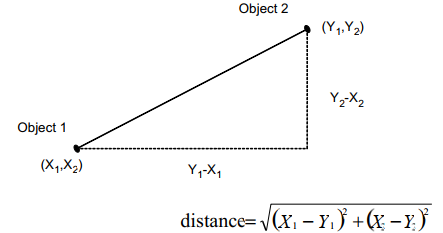
欧氏距离去掉根号。它不再是严格意义上的“距离”,但保留了大小排序信息: 越大,两点越远。
去掉根号带来两个好处:
- 求导更方便:聚类、最优化中经常要对距离求导,带根号的式子导数繁琐,平方形式则很干净;
- 可分解性:平方欧氏距离可以拆成各维度贡献之和,Ward 法的簇内平方和 正是基于这种分解。
统计距离
欧氏距离有两个致命弱点,用一个例子说明:假设有两个变量:收入(元) 和 年龄(岁)。
- 弱点一:量纲敏感。 收入差 5000 元、年龄差 5 岁,算欧氏距离时收入完全主导结果——年龄几乎被“淹没”了(我们在 3.4 节会介绍标准化)。
- 弱点二:忽略相关性。 设想数据点分布成一个倾斜的椭圆(收入与年龄正相关)。椭圆长轴方向上的波动是数据的自然变异,应该“算近一点”;短轴方向上偏离很多才是真正的异常,应该“算远一点”。而欧氏距离对各方向一视同仁,做不到这一点。
统计距离表达:
对于 ,一个常见的选择是
其中 为样本协方差矩阵。
当我们取 时,它也被称为马氏距离(Mahalanobis distance)。它不仅看两点相隔多远,还考虑数据的分布形状。这样,它就解决了欧氏距离的两个问题:
- 协方差矩阵的对角元素(各变量的方差)自动校正量纲——效果类似先标准化再算距离(标准化后算欧氏距离等价于取 的统计距离,参见 3.4 节);
- 非对角元素(协方差)考虑变量间的相关性,把椭圆“转正、拉圆”之后再量距离,各方向权重符合数据的真实分布。
闵可夫斯基度量(Minkowski metric)
闵可夫斯基度量则是一个统一的框架,前面的欧氏距离只是它的一个特例:
它通过参数 控制距离的“性格”。 取不同值时,就得到一系列熟悉的距离:
| 距离名称 | 特点 | |
|---|---|---|
| 曼哈顿距离(Manhattan / 城市街区距离) | 各维差值绝对值直接相加 | |
| 欧氏距离 | 我们熟悉的直线距离 | |
| 切比雪夫距离(Chebyshev) | 只看差距最大的那一维 |
的直觉在于, 越大,距离越被“大差距”的维度主导; 越小,各维度越“平等”。
这句话是什么意思?
举个具体例子。假设两个点在 3 个维度上的差值是:
看不同 下各维度的“贡献”(乘方后的值):
| 维度1(差10) | 维度2(差3) | 维度3(差1) | 距离值 | |
|---|---|---|---|---|
| 10 | 3 | 1 | ||
| 100 | 9 | 1 | ||
| 1000 | 27 | 1 | ||
| 主导一切 | 忽略不计 | 忽略不计 |
可以清楚看到:
- (曼哈顿距离):就是简单相加,每个维度都“有一票”,哪怕差 1 的小维度也算数。各维度平等。
- (欧氏距离):大差距被平方放大了(10→100),小差距被相对压制(3→9,1→1)。大维度开始“抢戏”。
- (切比雪夫距离):乘方使得最大的那个差值碾压所有其他维度,距离完全由差距最大的那一维决定,其他维度形同虚设。
直觉来说, 相当于一个“偏心旋钮”:
- 调大 → 数学上 占上风 → 距离反映“最差的那一维”(一票否决制)
- 调小 → 越接近简单的加总 → 距离反映“所有维度的总和”(人人有份)
所以: 决定了多维差距汇总时是“平均主义”还是“强者通吃”。这也解释了为什么表格里 时小维度影响大、 时只剩最大维度起作用。
闵可夫斯基度量与统计距离
| 闵可夫斯基度量 | 统计距离 | |
|---|---|---|
| 公式 | ||
| 处理量纲差异 | ❌ 不处理(对量纲敏感) | ✅ 马氏距离 的对角元素自动校正 |
| 处理变量相关性 | ❌ 各维度完全独立 | ✅ 的非对角元素处理相关性 |
| 灵活性来源 | 参数 (改变汇总方式) | 矩阵 (改变空间形状) |
| 典型代表 | 曼哈顿、 欧氏、 切比雪夫 | 马氏距离 |
闵可夫斯基度量把 维空间当成各向同性的——每个维度权重相同、维度之间互不相干。
而统计距离相当于先对空间做“变形”(拉伸、旋转),再量直线距离。例如我们在 3.1 节里提到的:马氏距离是把椭圆“转正、拉圆”之后再量距离。
在实践中:
- 如果变量之间可以视为独立,经过标准化后直接比较各维差异,就可以用闵可夫斯基距离;
- 如果变量尺度不同、存在明显相关性,而且能够可靠估计协方差结构,用统计距离,典型是马氏距离。
3.2 二元测量
对象对可以依据某些特征的有无来进行比较。
- 二元变量表示某特征的存在或缺失。
- 设 为第 个二元变量在第 个对象上的取值,取 或 ,其中
例如:
| 对象 | 变量 1 | 变量 2 | 变量 3 | 变量 4 | 变量 5 |
|---|---|---|---|---|---|
| 1 | 0 | 0 | 1 | 1 | |
| 1 | 1 | 0 | 1 | 0 |
二元变量的平方欧氏距离
它是:
- 不匹配的维度数。
- 当两个对象不相似时取值较大。
- 基于 - 匹配与 - 匹配同等权重。
然而,在某些情况下,- 匹配比 - 匹配更能表明相似性。
二元数据并不是总该使用欧氏距离,选择取决于 0 和 1 的含义:
- 对称二元变量:0 和 1 地位相同,例如性别编码或两个互斥状态。可以使用 Hamming、简单匹配距离或平方欧氏距离。
- 非对称二元变量:1 表示稀有且重要的“出现”,0 只是“未出现”,例如疾病、购买行为、关键词。共同为 0 通常不应算作重要相似度,此时更适合 Jaccard 距离:
对于上面的例子,
也就是说, 和 总共有 2 个不匹配的维度。
3.3 其他相似性系数
设匹配与不匹配的频数汇总如下:
| 对象 :1 | 对象 :0 | 合计 | |
|---|---|---|---|
| 对象 :1 | |||
| 对象 :0 | |||
| 合计 |
基于匹配比例的度量包括:
| 公式 | 依据 |
|---|---|
| - 匹配与 - 匹配同等权重 | |
| 分子中不含 - 匹配 | |
| - 匹配与 - 匹配赋予双倍权重 | |
| 不匹配对赋予双倍权重 |
例子
| 对象 :1 | 对象 :0 | 合计 | |
|---|---|---|---|
| 对象 :1 | 2 | 1 | 3 |
| 对象 :0 | 1 | 1 | 2 |
| 合计 | 3 | 2 | 5 |
因此,
- 普通匹配比例,将两种匹配视为同等重要:
- 适合 0 和 1 地位对称的变量。
- 只奖励共同出现,只算 1-1,不看 0-0:
- 适合 1 代表重要事件的出现,而 0 只是未出现的情形。
- 给匹配双倍权重,每个匹配贡献 2 分,每个不匹配贡献 1 分:
- 强调“相同”的证据。
- 给不匹配双倍权重:
3.4 标准化
相似性度量对量纲(尺度)敏感,离散程度大的变量对最终相似性值的影响更大。
对于观测 和变量 ,按变量进行的标准化为
标准化得分:
- 消除量纲问题。
- 等价于使用统计距离并取
其中 为整个数据集的样本协方差矩阵。
要注意,这里的 表示只留下 的对角元素,并把所有协方差设为 0,等价于各变量标准化后再计算欧氏距离的平方,要和前面的 马氏距离区分开。
例子
| 对象 | 购买概率 | 广告观看时长(分钟) | 广告观看时长(秒) | 标准化购买概率 | 标准化观看时长 |
|---|---|---|---|---|---|
| A | 60 | 3.0 | 180 | -1.06 | -1 |
| B | 65 | 3.5 | 210 | 0.93 | 0 |
| C | 63 | 4.0 | 240 | 0.13 | 1 |
欧氏距离:
| 配对 | 时长(分钟) | 排名 | 时长(秒) | 排名 | 标准化值 | 排名 |
|---|---|---|---|---|---|---|
| A-B | 5.025 | 3 | 30.41 | 2 | 2.22 | 2 |
| A-C | 3.162 | 2 | 60.07 | 3 | 2.33 | 3 |
| B-C | 2.062 | 1 | 30.06 | 1 | 1.28 | 1 |
以 A-B 对为例,使用分钟进行计算:
而购买概率不变,把分钟改成秒,也就是观看时长乘以 60 后,从上面的表格可以看出,A、B、C 本身没有发生任何实质变化,只是观看时长从分钟换成了秒,A-B 和 A-C 的排名却互换了。
原因是秒数的差异比分钟数大 60 倍;平方以后,其距离贡献变成原来的 倍,于是观看时长几乎完全支配了欧氏距离。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放